Любая аналитика начинается с того, что данные нужно доставить из источников в одно место. Этот процесс называют интеграцией данных, а самые частые его варианты обозначают аббревиатурами ETL и ELT. Разница между ними небольшая по названию, но заметная по последствиям.
Как работает ETL
ETL расшифровывается как Extract, Transform, Load: извлечь, преобразовать, загрузить.
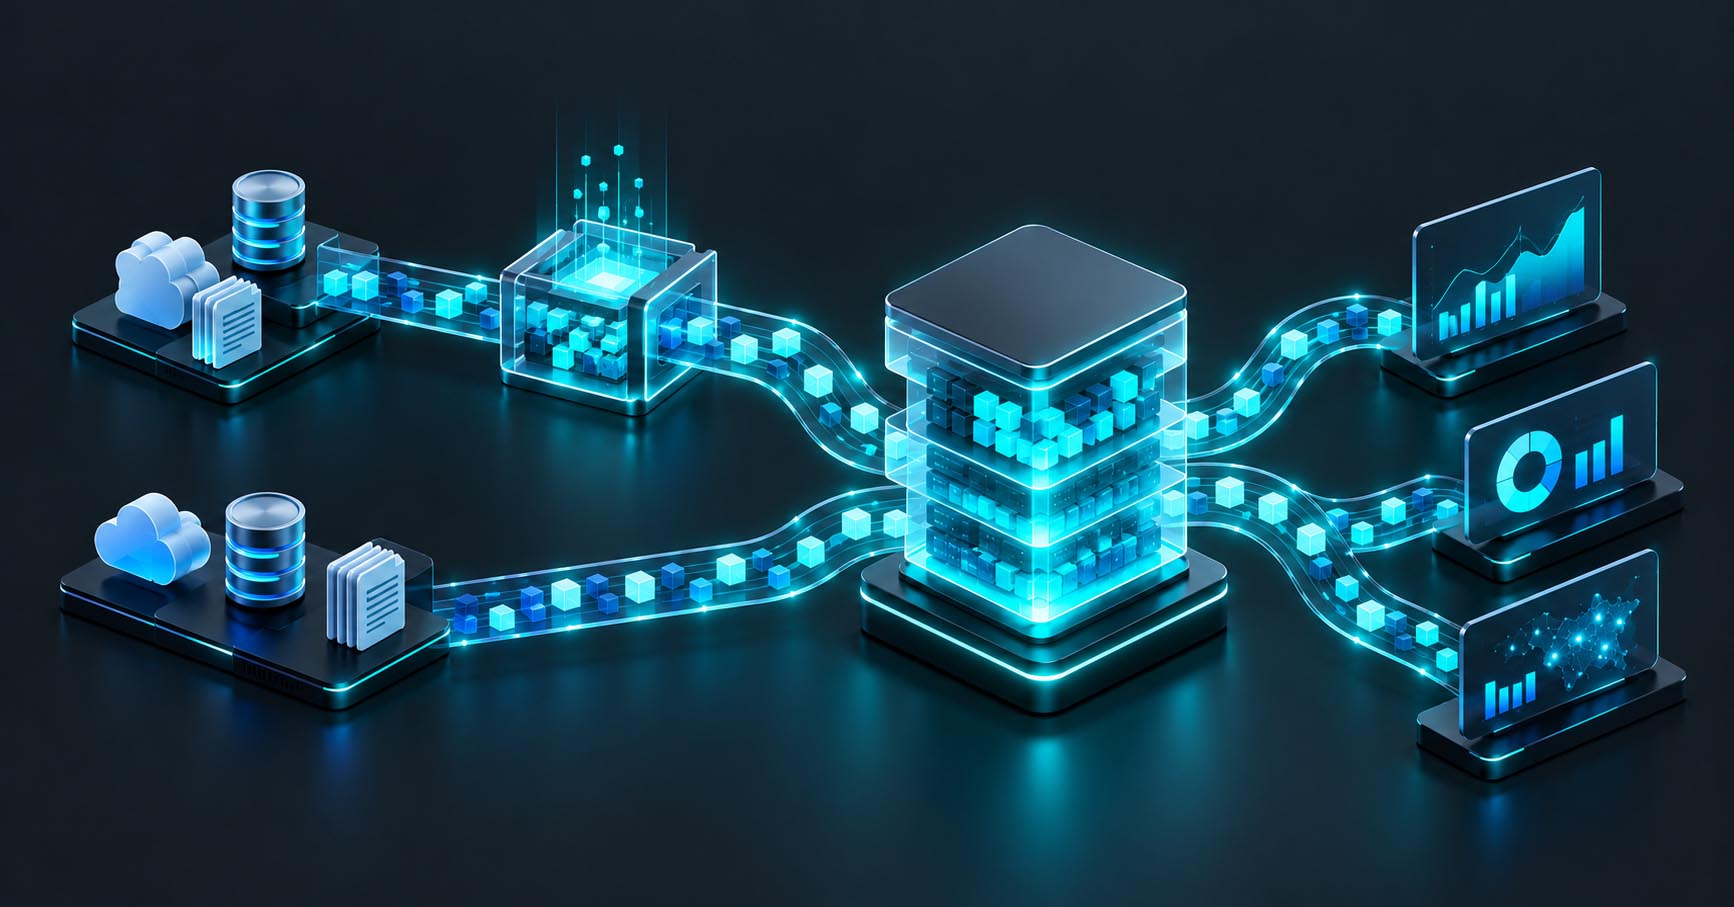
- Данные извлекаются из источников (учётные системы, CRM, файлы, API).
- Они преобразуются на отдельном сервере или в специальном инструменте: очищаются, приводятся к единому формату, объединяются.
- Готовый результат загружается в хранилище.
В хранилище попадают уже подготовленные данные.
Как работает ELT
ELT это Extract, Load, Transform: извлечь, загрузить, преобразовать.
- Данные извлекаются из источников.
- Они загружаются в хранилище почти как есть, в виде «сырого» слоя.
- Преобразование выполняется внутри хранилища, как правило запросами на SQL.
Сравнение
| Параметр | ETL | ELT |
|---|---|---|
| Где преобразуются данные | На отдельном сервере до загрузки | В самом хранилище после загрузки |
| Что хранится | Только подготовленные данные | Сырые данные и подготовленные слои |
| Гибкость | Изменение логики требует перезагрузки из источников | Логику можно поменять и пересчитать историю |
| Нагрузка | На сервер преобразования | На хранилище |
| Когда подходит | Строгие требования к данным до загрузки, слабое хранилище | Современные хранилища, быстро меняющиеся требования |
Почему ELT стал популярным
Современные аналитические хранилища хорошо справляются с большими объёмами и сложными запросами, а хранение стало недорогим. Поэтому проще загрузить всё в сыром виде и выбирать способ обработки позже. Если логика расчёта изменилась, не нужно заново обращаться к источникам: достаточно пересчитать данные внутри хранилища. Кроме того, преобразования, написанные на SQL, понятны аналитикам, а не только разработчикам.
Когда ETL остаётся уместным
- Чувствительные данные. Если персональные или коммерческие данные нужно маскировать до того, как они попадут в общее хранилище.
- Ограниченное хранилище. Когда нет смысла хранить большие объёмы сырых данных.
- Сложная очистка. Когда данные нужно сильно преобразовывать, а возможности SQL недостаточно.
- Строгие требования безопасности. Когда сырые данные нельзя размещать в целевой среде.
На практике чаще всего гибрид
В реальных проектах редко выбирают что-то одно. Типичная схема: данные загружаются в сырой слой (ELT-подход), дальше строятся слои очищенных данных и витрин для отчётов, а чувствительные поля маскируются на входе (элементы ETL). Важнее продумать слои и правила, чем следовать аббревиатуре.
Что важнее выбора подхода
Надёжность загрузки влияет на результат сильнее, чем выбор между ETL и ELT. Обратите внимание на:
- Повторный запуск. Если загрузка упала, её можно перезапустить без дублей в данных.
- Журналы и оповещения. Об ошибке узнаёт ответственный, а не пользователь отчёта.
- Проверки качества. Пропуски, дубли и резкие изменения объёма выявляются автоматически.
- Расписание и порядок. Задачи зависят друг от друга, и инструмент оркестрации контролирует последовательность.
- Документация. Понятно, откуда берётся каждый показатель и кто за него отвечает.
Вопросы, которые стоит задать перед выбором
- Где будет жить хранилище и насколько оно производительное?
- Есть ли данные, которые нельзя загружать без обработки?
- Как часто меняются правила расчёта показателей?
- Кто будет поддерживать преобразования: разработчики или аналитики?
- Нужна ли история в сыром виде для будущих задач?
Частые вопросы
Нужно ли выбирать только один подход? Нет. В проектах часто сочетают: основная масса данных загружается по схеме ELT, а чувствительные поля обрабатываются до загрузки, как в ETL.
Какие инструменты используются? Подбираются под задачу и требования безопасности: оркестраторы, преобразования на SQL, потоковые решения, например Airflow, dbt и Kafka.
Как понять, что загрузка надёжна? Её можно безопасно перезапустить, об ошибках узнаёт ответственный, а качество данных проверяется автоматически.
Что дальше
Как мы проектируем и сопровождаем загрузку данных, описано на странице Инжиниринг данных. Если вы выбираете архитектуру хранилища, посмотрите также Корпоративное хранилище (DWH) или расскажите о своей задаче.